Von SEO zu AXO
Zwei Jahrzehnte lang bedeutete Sichtbarkeit für eine Website eine Disziplin: SEO — Suchmaschinenoptimierung. Man schrieb für den Crawler, und die Engine schickte Menschen.
Dieses Zeitalter weitet sich leise. Immer mehr Menschen suchen und klicken nicht — sie fragen einen Assistenten. Sie stellen Claude, ChatGPT, Perplexity, Gemini eine Frage, und der Assistent liest das Web in ihrem Auftrag und berichtet zurück. Der Assistent ist der Besucher; die Person sieht die Seite nie.
Es gibt also eine zweite Disziplin neben SEO, und sie beginnt einen Namen zu haben: AXO — Agent Experience Optimization. Wo SEO eine Seite für eine Such-Maschine justierte, justiert AXO sie für den Agenten, der im Auftrag einer Person liest und handelt — für Agenten, was UX für Menschen ist. (Man sieht auch GEO und AEO, Generative- und Answer-Engine-Optimierung. Die sind enger — vor allem darum, zitiert zu werden in einer KI-Antwort. AXO ist das Breitere: eine Site, die ein Agent tatsächlich nutzen kann.)
Die Verschiebung ist nicht subtil, wenn man Server-Logs anschaut. KI-Crawler-Traffic — GPTBot, ClaudeBot, PerplexityBot und ein langer Schweif weniger höflicher Cousins — ist inzwischen ein spürbarer Anteil der eingehenden Requests auf den meisten Sites. Das Verhalten hat sich geändert, bevor das Vokabular nachkam.
Was auf dem Spiel steht
Drei konkrete Dinge folgen aus einer AXO-Investition.
Genauigkeit und Attribution. Wenn ein Agent einen sauberen Weg hat, eine Site zu lesen, zitiert er korrekt und verlinkt zurück auf die richtige Seite. Wenn nicht, scrapt er — und was am anderen Ende herauskommt, ist, was den Scrape überlebt hat. Eine selbstbewusste Paraphrase der eigenen Arbeit in der Antwort eines anderen Assistenten, ohne Link zurück, ist schlimmer als gar keine Erwähnung. Über die Arbeit wird gesprochen; die einzige Frage ist, ob die Anerkennung bei einem landet.
Ein neuer Entdeckungskanal. Ein wachsender Anteil dessen, was früher „Suche“ war, geschieht inzwischen in einem Assistenten. Menschen stellen dort substanzielle Fragen, die sie nie in Google tippten. Eine Site, die ein Agent sauber lesen kann, taucht in diesen Antworten auf; eine, mit der er kämpft, wird übersprungen — und der Leser weiß nie, dass es einen gab. Der Traffic ist real, die Attribution ist anders, und sehr wenige Sites in einer Kategorie achten wahrscheinlich schon darauf.
Ein Fenster, in dem Frühsein noch zählt. AXO-Standards setzen sich noch. Sites, die sie jetzt übernehmen, erscheinen überproportional in den KI-Antworten, denen Menschen zu vertrauen beginnen. In zwei Jahren wird das Alltagspraxis sein; heute ist es ein leiser Vorsprung.
Wie AXO tatsächlich aussieht
Drei schlichte Dinge, in steigender Aufwandstufe. Nichts davon ist exotisch.
Eine Guide-Datei. llms.txt ist eine kleine Klartextdatei an der Wurzel einer Site — ein Geschwister von robots.txt. Sie sagt einem Agenten in klarer Sprache, was die Site enthält und wo die wichtigen Seiten liegen. Ein paar hundert Wörter, handgeschrieben, aktuell gehalten.
Saubere Struktur. Ordentliche Überschriften, semantisches HTML, schema.org-Markup, sinnvolle URLs. Die meisten Sites haben das meiste davon schon. AXO geht weitgehend darum, es nicht rückgängig zu machen — die Site lesbar zu halten, statt alles in clientseitiges JavaScript zu vergraben, das ein Agent nicht ausführen kann.
Eine Ask-Schnittstelle. Das ist der substanzielle Schritt, und der Teil, den die meisten „AI-SEO“-Ratgeber überspringen. Statt einen Agenten scrapen und raten zu lassen, bietet die Site einen kleinen, standardisierten Weg, gefragt zu werden — „finde mir die Seiten über X“ — und die tatsächlich relevanten Passagen mit Links zurückzugeben. Der entstehende Standard ist das Model Context Protocol (MCP). Für KI-Agenten ist es ungefähr das, was eine Steckdose für Geräte ist: eine vereinbarte Form, damit Dinge ohne Sonderfälle verbinden. Ein Agent, der einsteckt, kann das Schreiben durchsuchen und es genau zitieren, statt eine Paraphrase aus einem Scrape zu erfinden.
Ich habe es zuerst auf unseren eigenen Sites gebaut
Bevor ich das als allgemeines Muster aufschreibe, habe ich den vollen Stack auf der Familie von Sites gefahren, die ich betreibe — jueewo.ventures, aipokit.com, yawninghero.com, jueewo.com und juergenwoeckl.com. Fünf Sites, ein gemeinsamer MCP-Server unter mcp-sites.appkask.com, jeder veröffentlichte Artikel und jede Seite indexiert. Jede Behauptung, die folgt, kommt aus der Implementierung, nicht aus einem Slide-Deck.
Der geradlinige Test: Claude Desktop (oder Claude Code) mit dem Server verbinden, dann eine Frage stellen, die über mehrere Seiten auf mehreren Sites hinweg denken muss. Wir wählten eine mit echter Tiefe im Korpus:
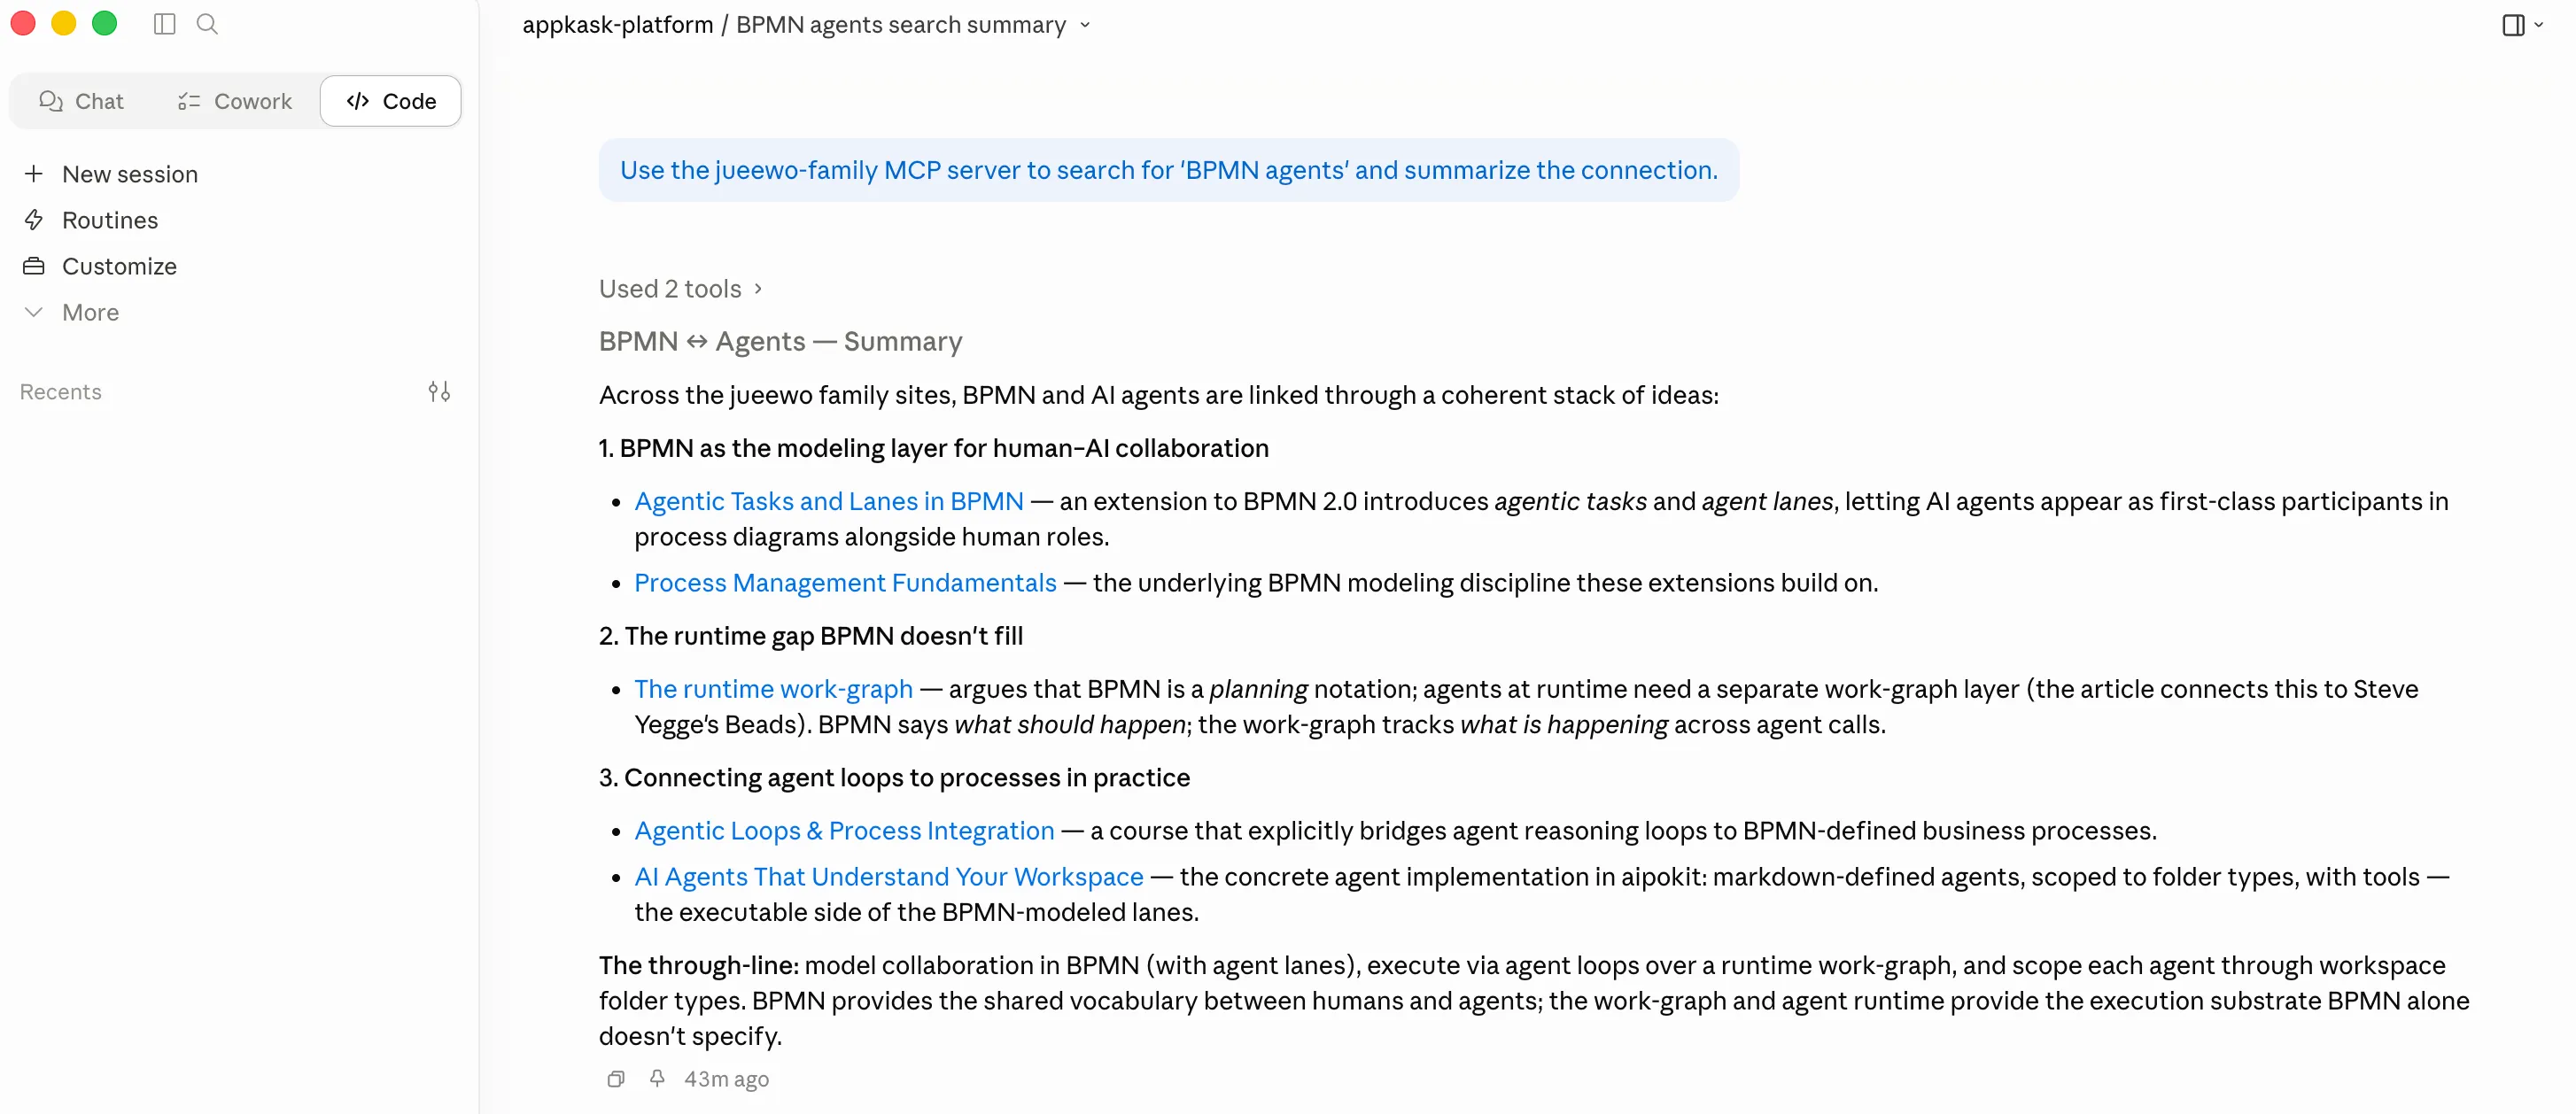
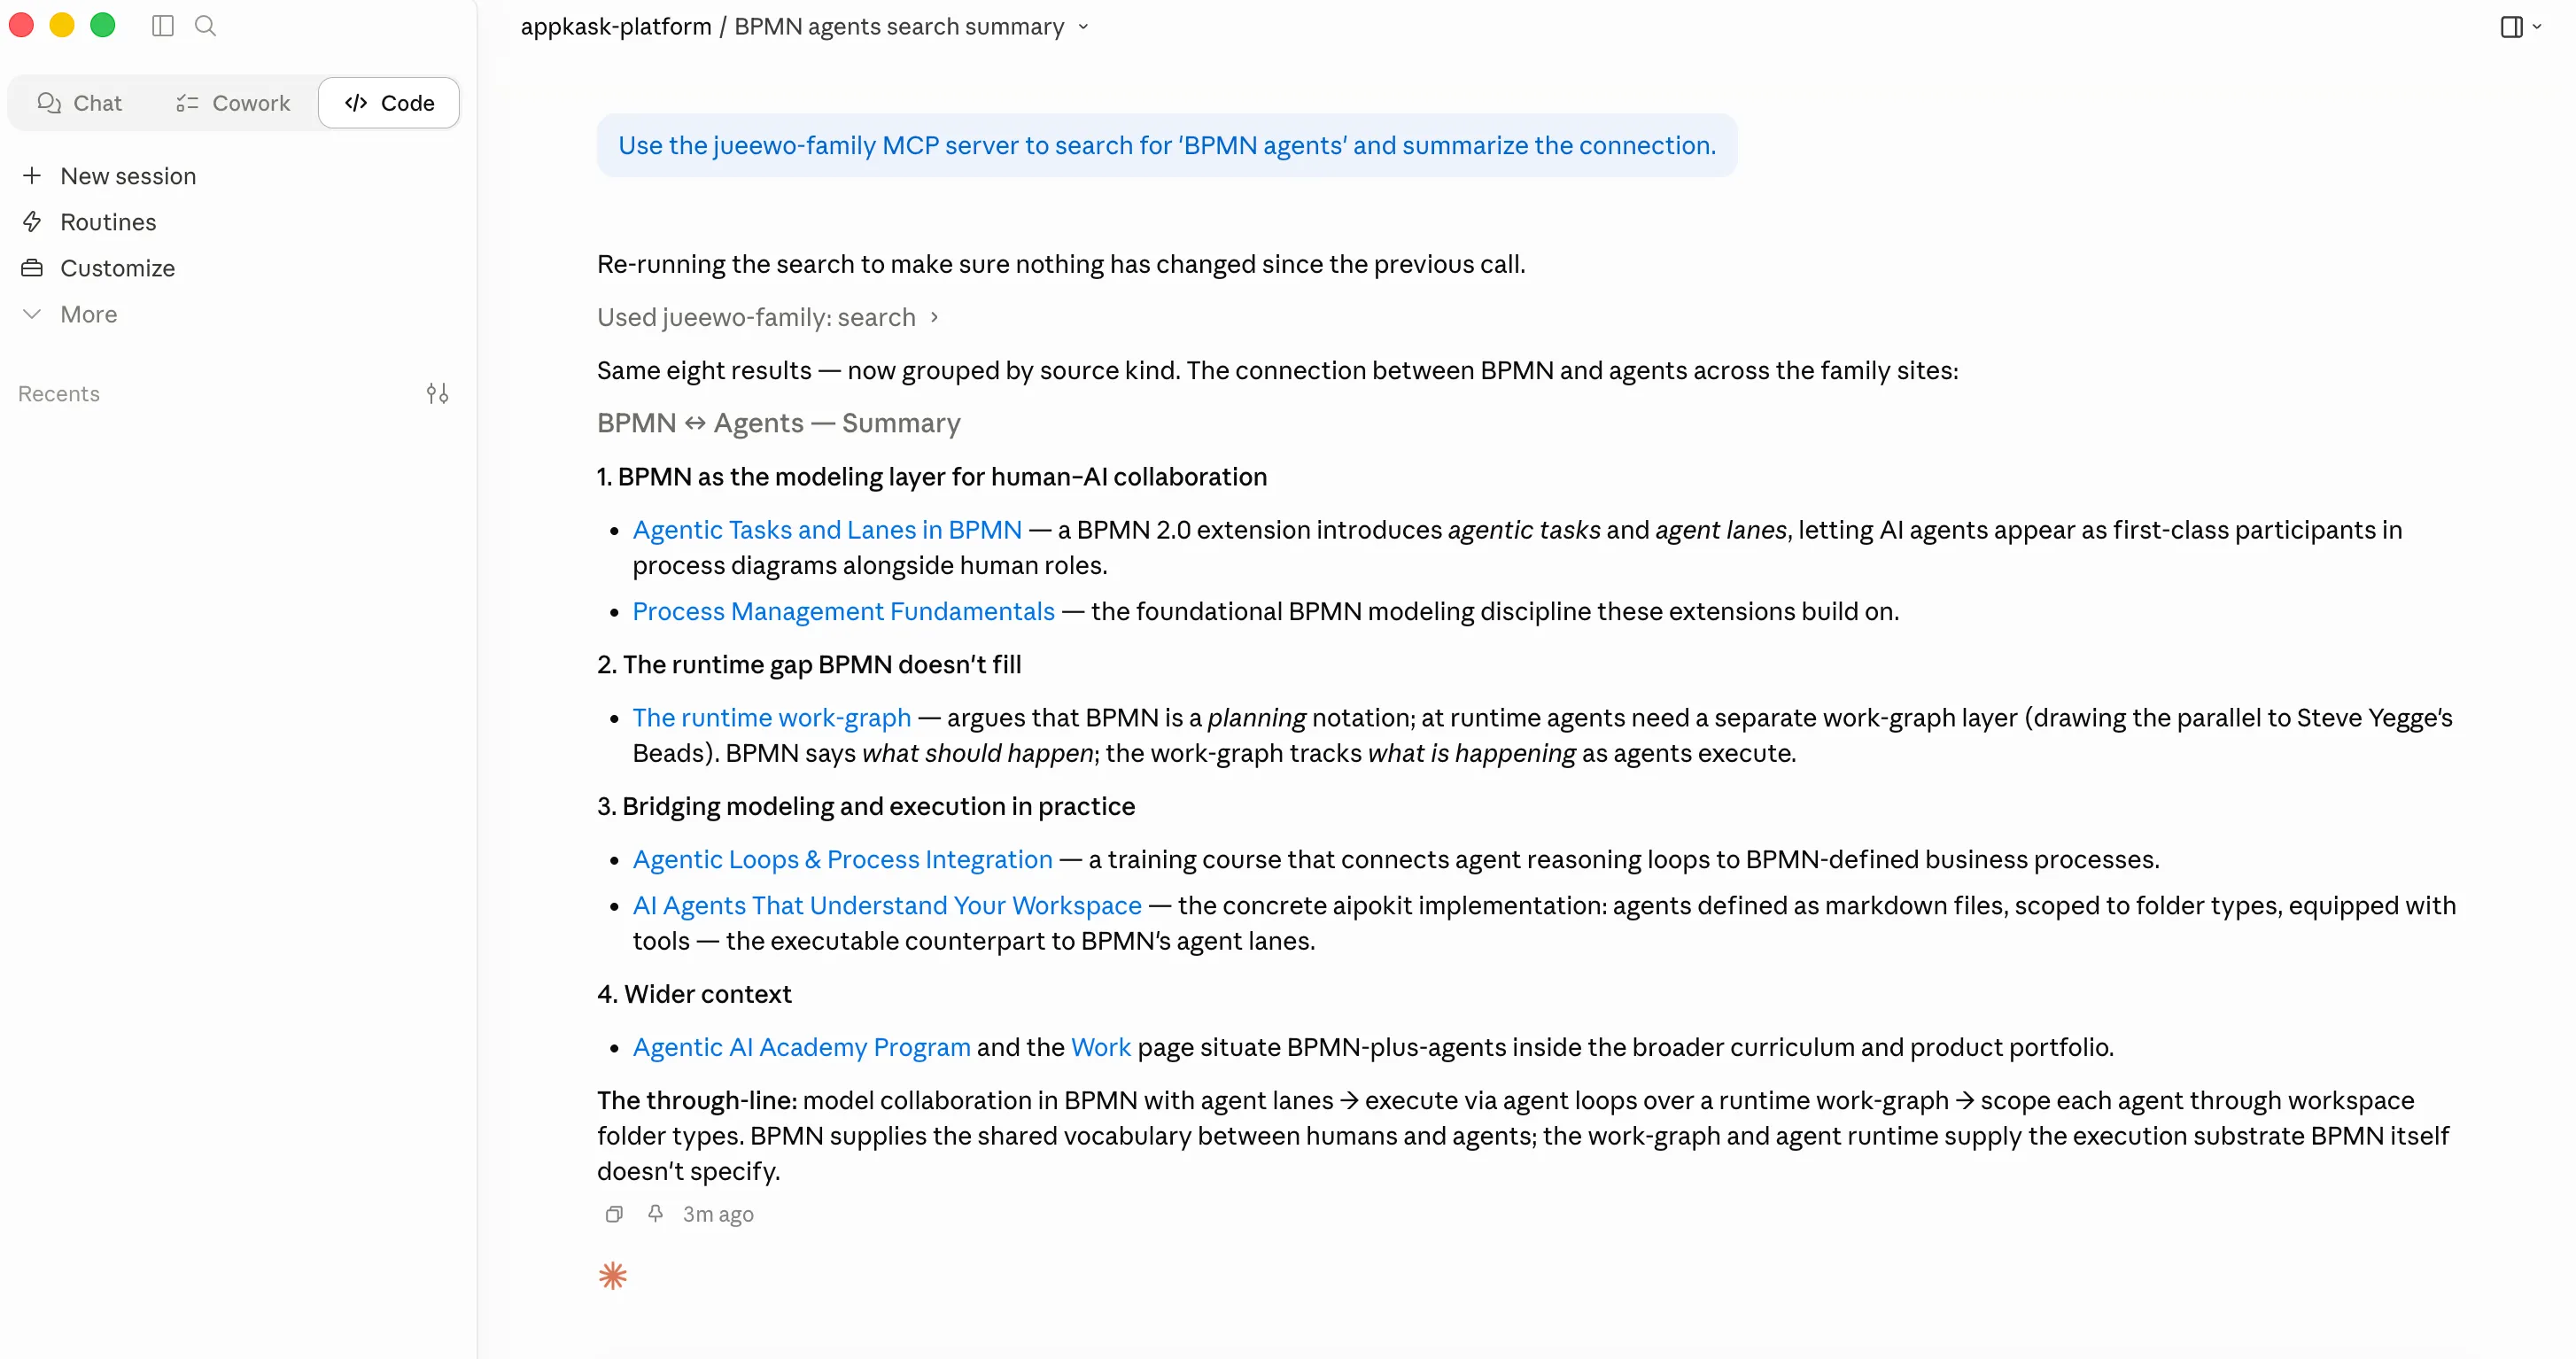
„Use the jueewo-family MCP server to search for ‘BPMN agents’ and summarize the connection.“
Was der Assistent produzierte — ohne eine einzige HTML-Seite zu rendern — steht unten wörtlich. Die Struktur ist seine; der Inhalt ist unserer.
BPMN ↔ Agents — Summary
Across the jueewo family sites, BPMN and AI agents are linked through a coherent stack of ideas:
1. BPMN as the modelling layer for human–AI collaboration. A BPMN 2.0 extension introduces agentic tasks and agent lanes, letting AI agents appear as first-class participants in process diagrams alongside human roles. Process Management Fundamentals is the underlying modelling discipline these extensions build on.
2. The runtime gap BPMN doesn’t fill. The runtime work-graph argues that BPMN is a planning notation; at runtime, agents need a separate work-graph layer (drawing the parallel to Steve Yegge’s Beads). BPMN says what should happen; the work-graph tracks what is happening as agents execute.
3. Bridging modelling and execution in practice. Agentic Loops & Process Integration connects agent reasoning loops to BPMN-defined business processes. AI Agents That Understand Your Workspace is the concrete workspace implementation: agents defined as markdown files, scoped to folder types, equipped with tools — the executable counterpart to BPMN’s agent lanes.
The through-line: model collaboration in BPMN with agent lanes → execute via agent loops over a runtime work-graph → scope each agent through workspace folder types. BPMN supplies the shared vocabulary between humans and agents; the work-graph and agent runtime supply the execution substrate BPMN itself does not specify.
Zwei Screenshots aus der Session selbst — die Synthese des Assistenten über einem einzelnen MCP-search-Aufruf. Zwischen dem ersten und dem zweiten Lauf haben wir eine kleine Änderung am Server ausgeliefert: Ergebnisse, die als flache Liste kamen, kommen jetzt nach Quellenart gruppiert, sodass die strukturelle Form des Korpus das Modell direkt erreicht, statt aus URL-Mustern erschlossen zu werden.
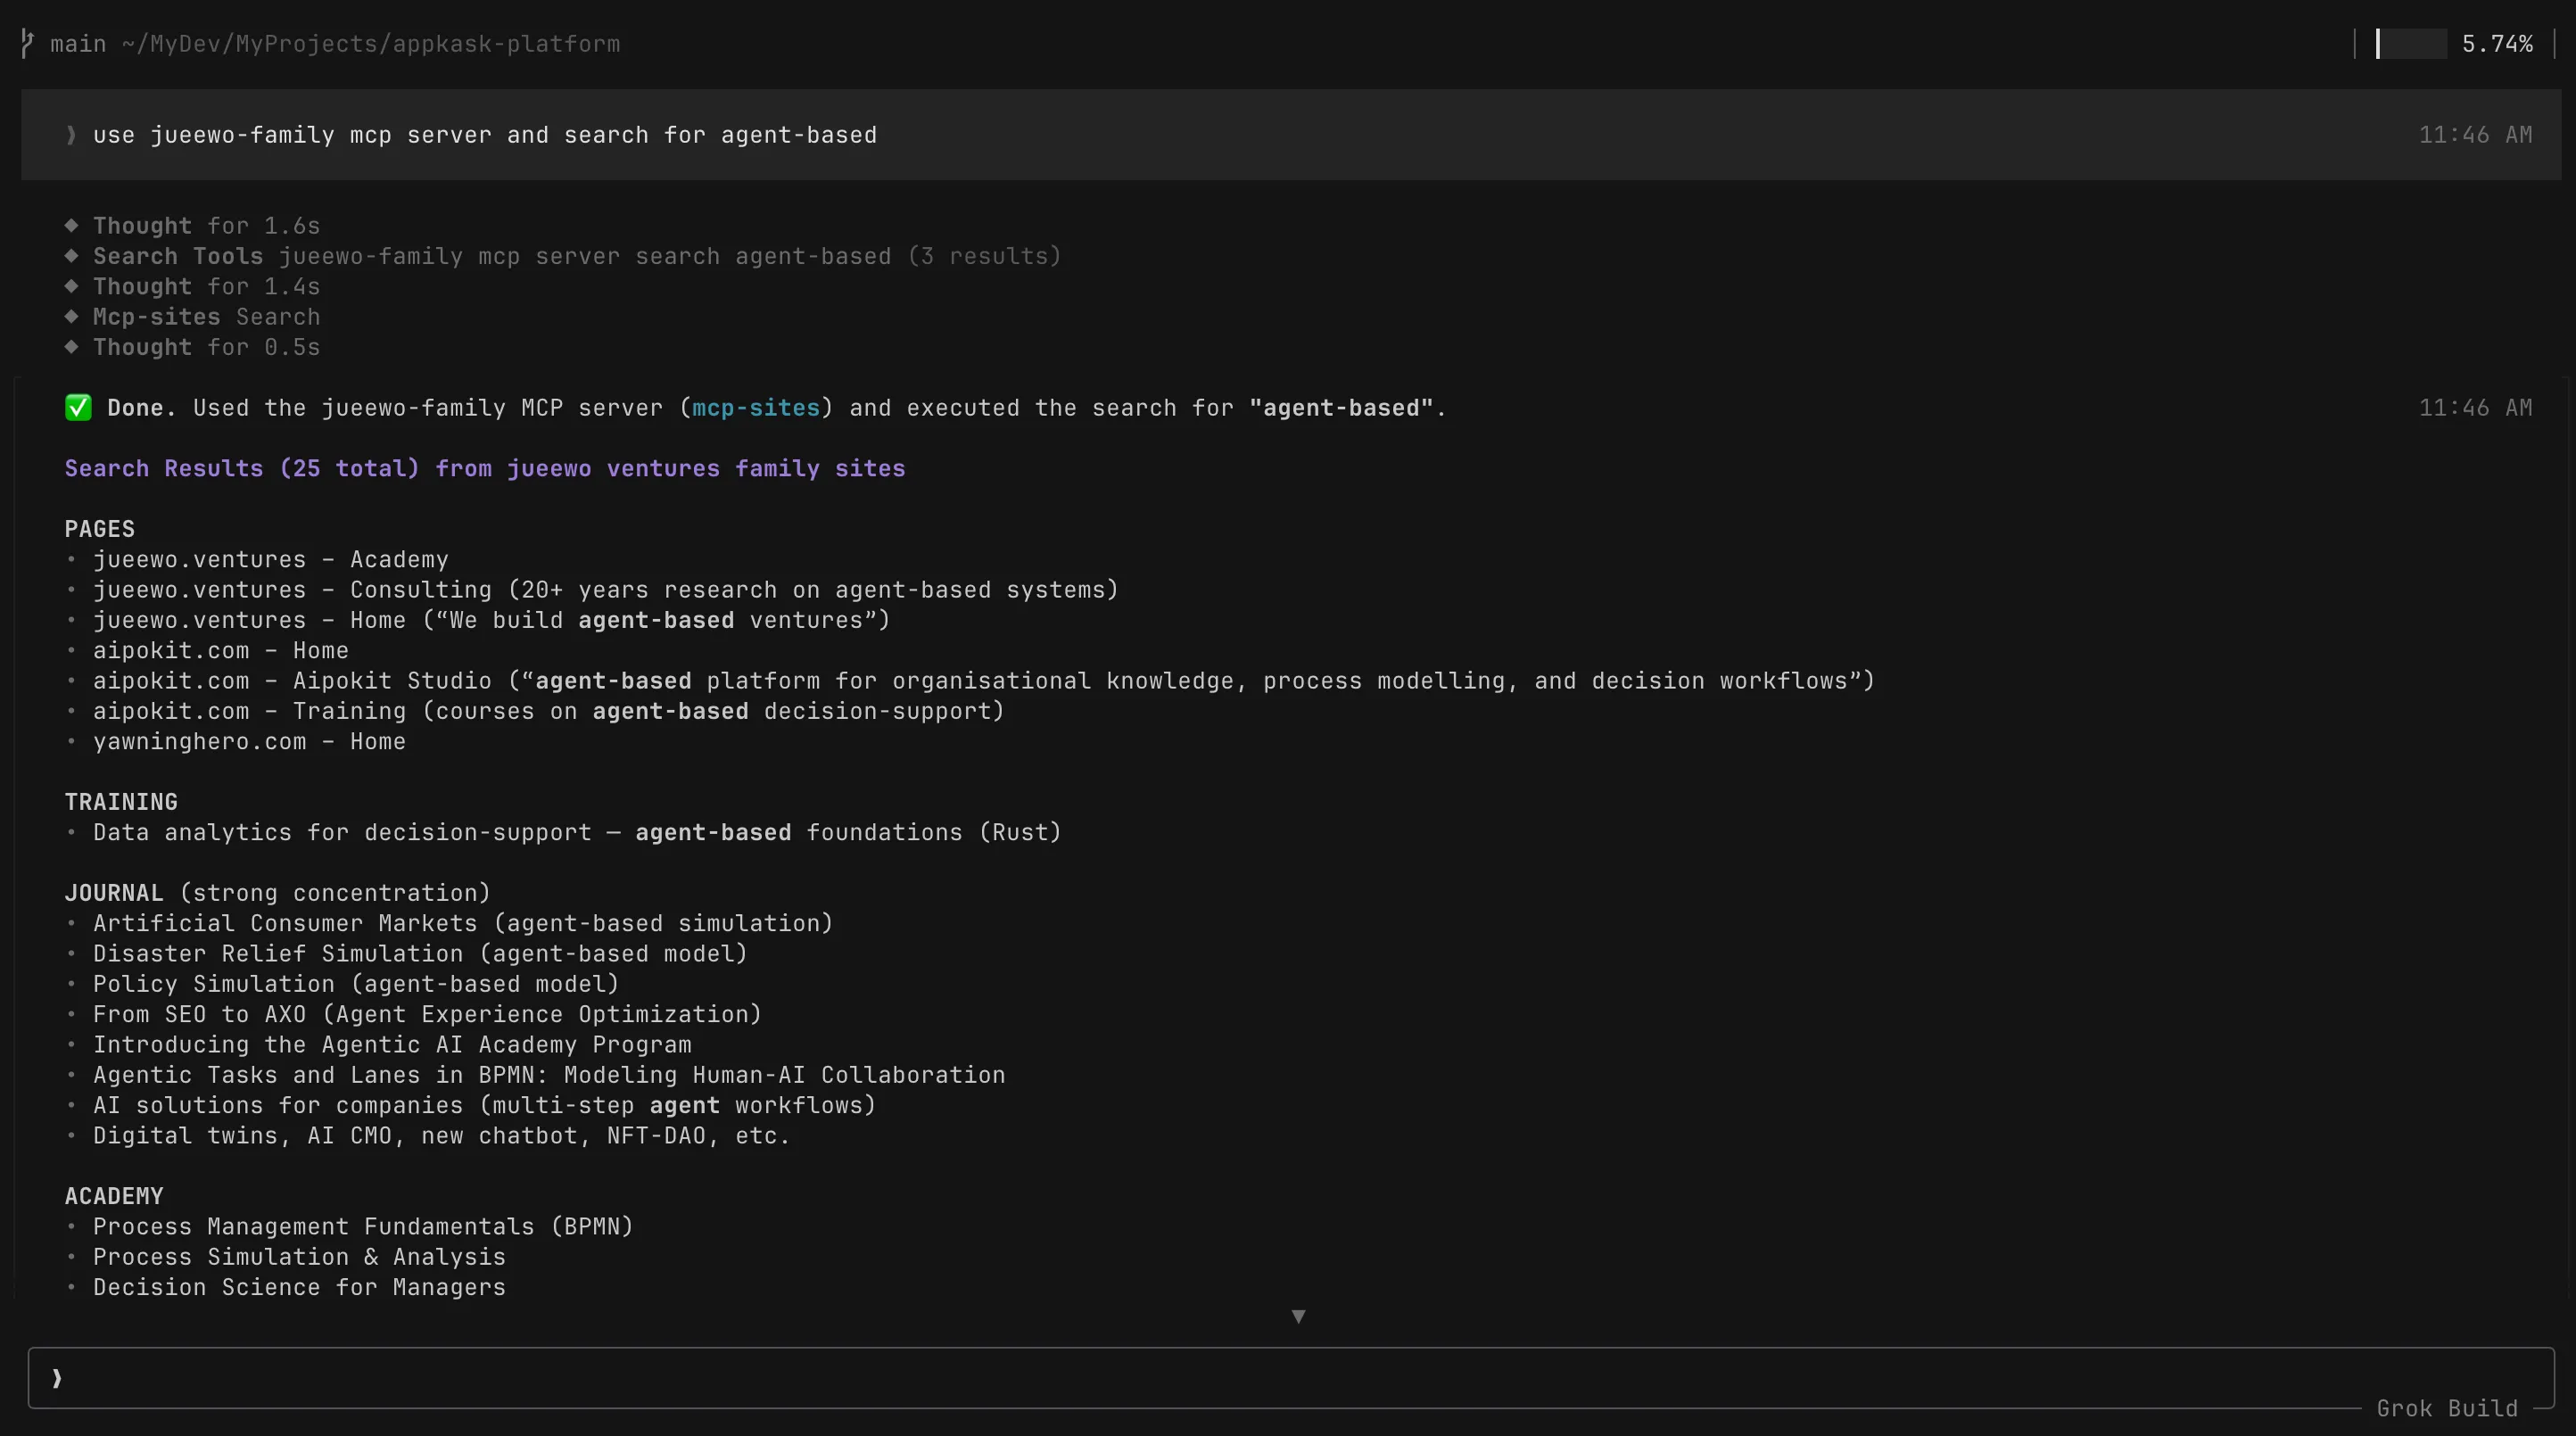
Und der Assistent selbst ist nicht der Punkt — das Protokoll ist es. Der dritte Screenshot unten ist derselbe MCP-Server, aufgerufen von einem ganz anderen Anbieter: Grok, über xAIs Build-Modus. Derselbe Server, dieselben Antworten, anderer Assistent. Eine AXO-Investition ist keine Wette auf Claude oder ein einzelnes Modell; sie funktioniert überall, wo ein MCP-Client lebt, und das Feld konvergiert schnell darauf.
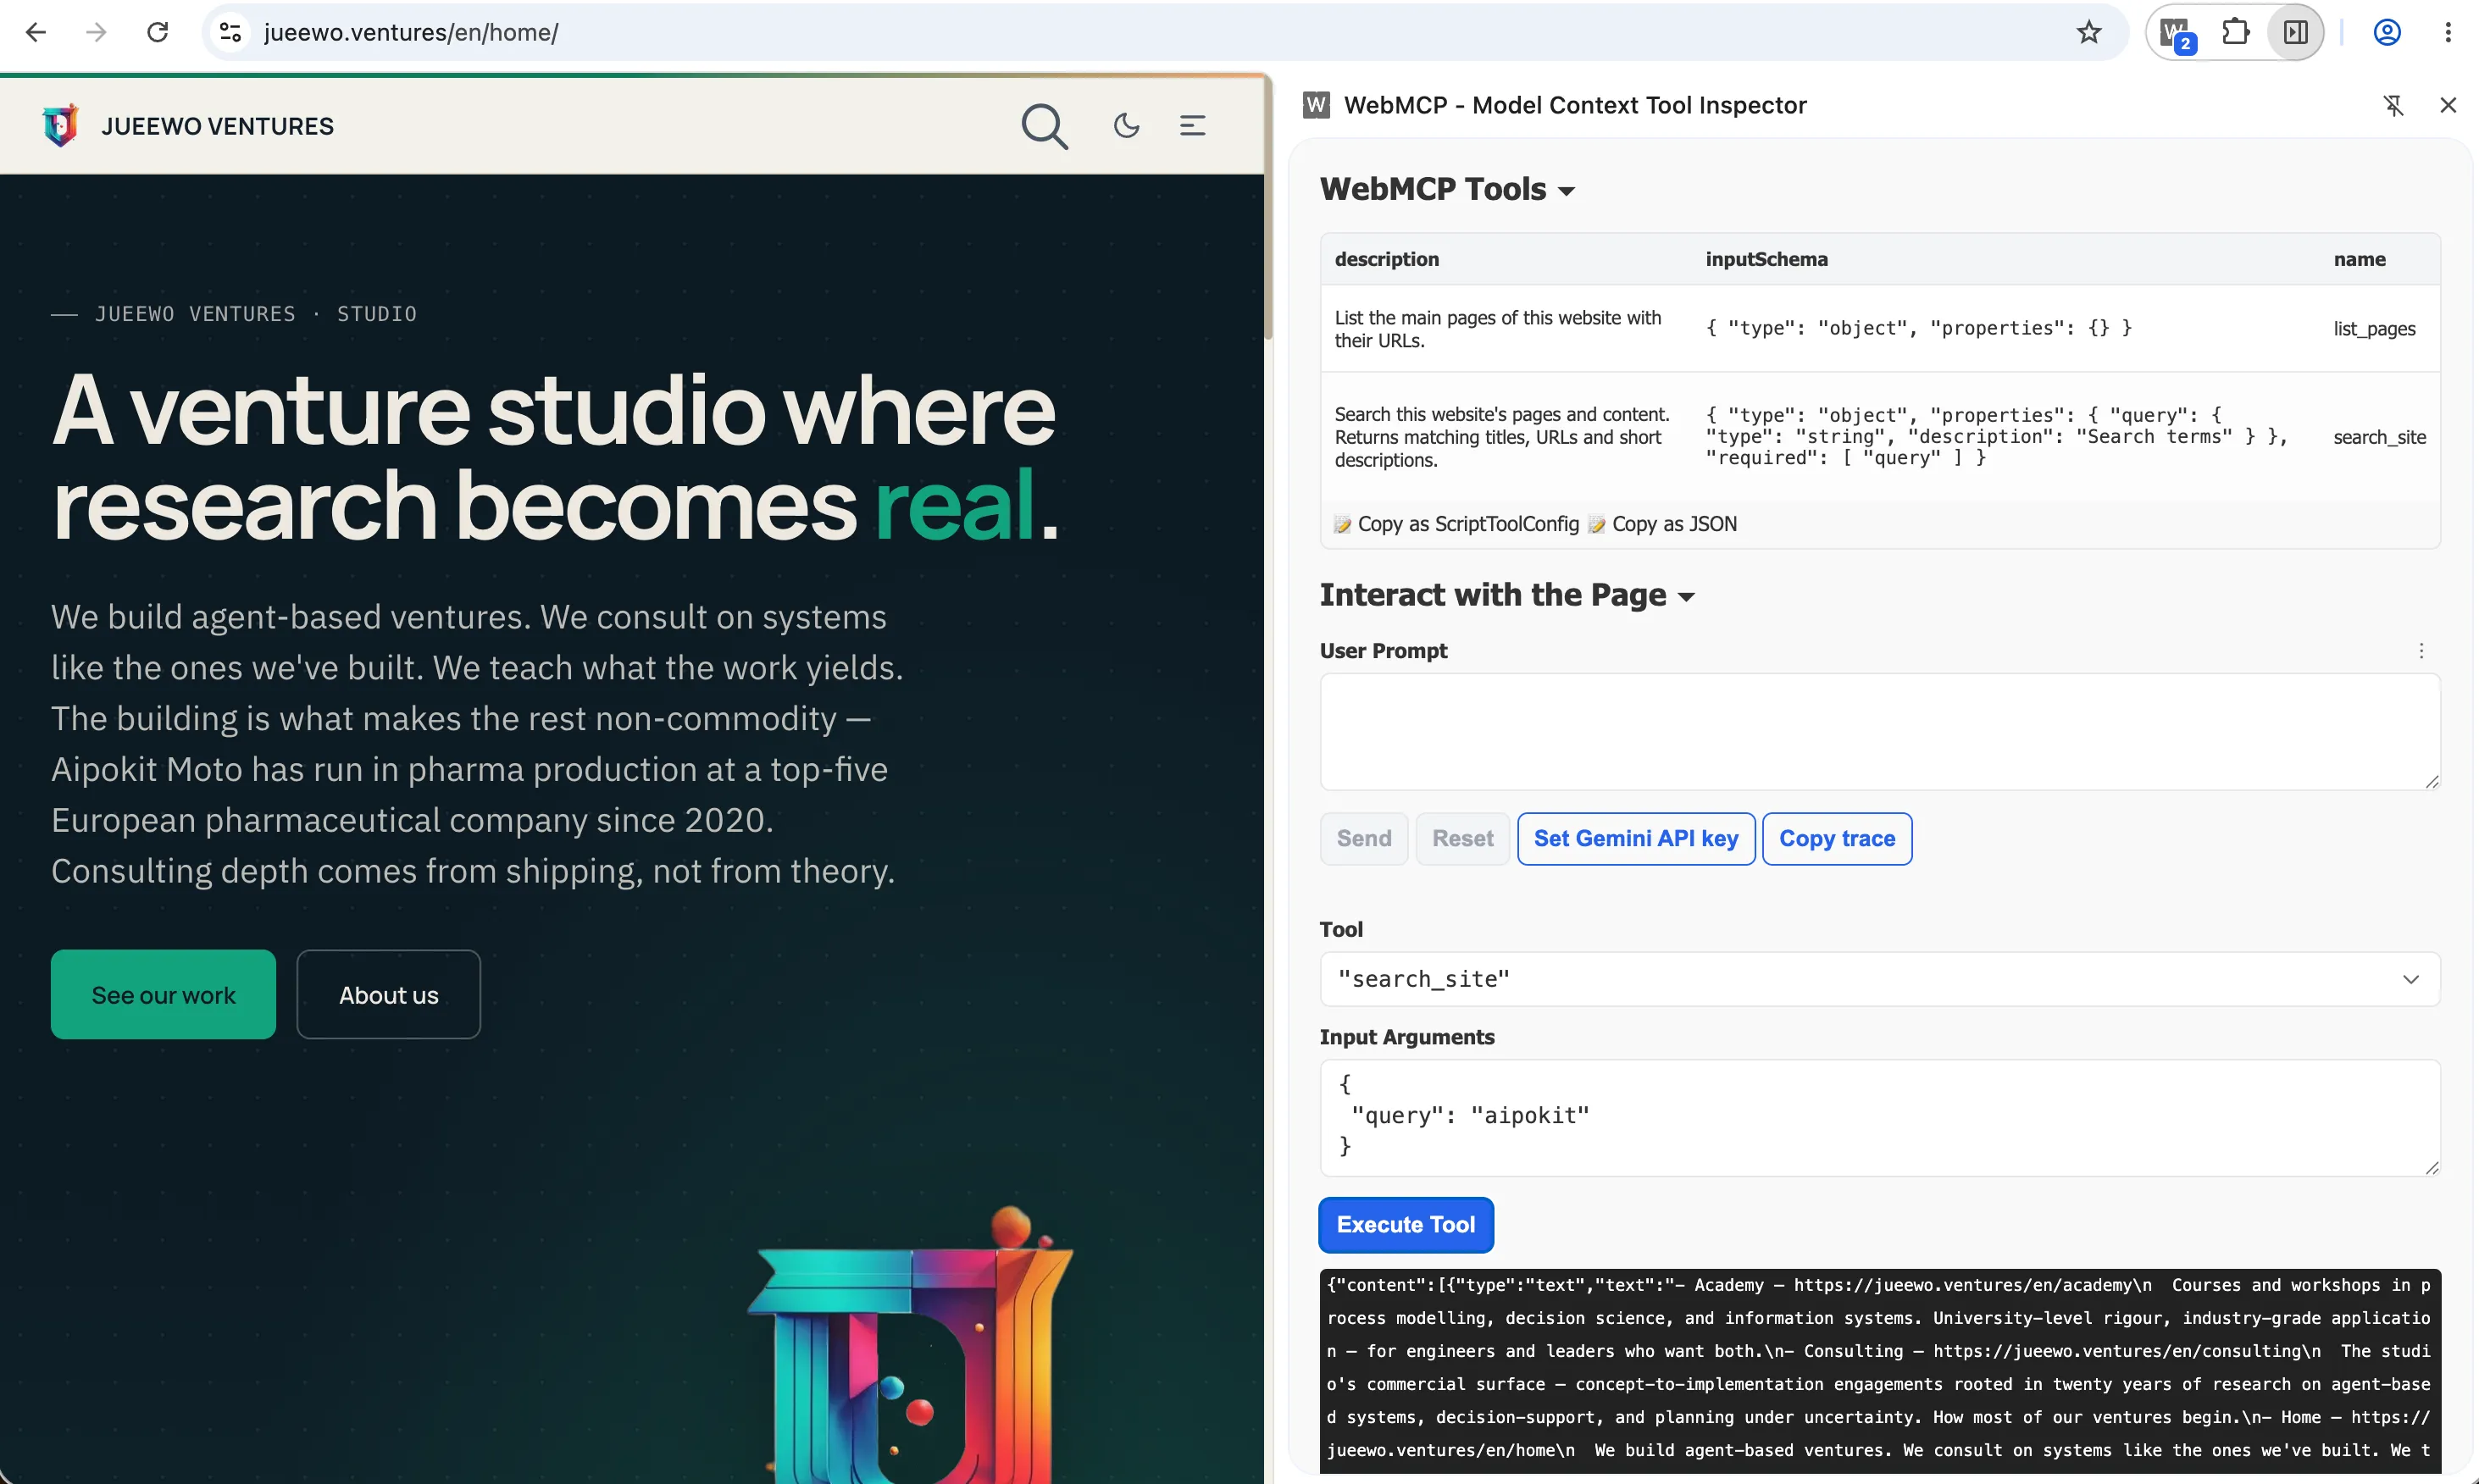
Und es gibt noch eine AXO-Oberfläche, die sich zu zeigen lohnt — strukturell anders als das server-seitige Muster oben. WebMCP lässt eine Seite eigene Tools einem Assistenten exponieren, der im Browser des Besuchers läuft. Statt dass ein externes Claude oder Grok einen gemeinsamen MCP-Server irgendwo im Internet aufruft, ruft der eigene Browser-Assistent des Besuchers Tools auf, die die Seite selbst deklariert — während die Person darauf ist. Der Screenshot unten zeigt einen WebMCP-Inspector auf jueewo.ventures mit den Tools — list_pages, search_site —, die die Seite anbietet. Zwei komplementäre Muster nebeneinander: externe Agenten erreichen den gemeinsamen MCP-Server; In-Browser-Assistenten erreichen die Seite direkt.
Mehreres an diesen Synthese-Läufen lohnt Beachtung.
Er zitiert fünf distinkte Quellen über zwei Sites — vier Journal-Artikel und ein Produkt-Update — und einen Trainingskurs als unterstützenden Kontext. Jeder Name in Kursivschrift ist eine echte Seite auf einer dieser Sites.
Er synthetisiert eine rote Linie, die die einzelnen Artikel nie in diesen Worten aussprechen („BPMN sagt, was geschehen sollte; der Work-Graph verfolgt, was geschieht“). Diese Synthese ist nur möglich, weil das Modell zugleich sauberen, strukturierten Zugang zum Korpus hatte. Ein Scraper hätte eine Montage von Absätzen produziert; der Assistent produzierte ein Argument.
Er unterscheidet Artikel von Trainingskurs von Produkt-Update — die strukturelle Form des Korpus ist für das Modell sichtbar, nicht aus URL-Mustern erschlossen.
Das ist, was AXO in der Praxis liefert. Nicht „in einer KI-Antwort auftauchen“, was zu klein gerahmt ist, sondern: ein Agent, der über veröffentlichtes Werk als erstklassige Quelle nachdenkt, es zitiert, darauf aufbaut, es verbindet.
Selbst ausprobieren
Der Server ist öffentlich und braucht keine Anmeldung. Jede Aussage in dieser Notiz lässt sich also mit dem eigenen Assistenten prüfen.
- In einem Client, der Remote-MCP-Server unterstützt, etwa Claude Desktop, Claude Code, Cursor oder Grok, einen Server mit der Adresse
https://mcp-sites.appkask.com/mcphinzufügen. In Claude Code zum Beispiel:claude mcp add --transport http sites https://mcp-sites.appkask.com/mcp. - Eine Frage stellen, die mehrere Seiten verbindet, etwa „Suche über den Sites-MCP-Server nach ‚BPMN Agenten‘ und fasse den Zusammenhang zusammen.“
- Oder kleiner anfangen: „Welche Sites indexiert dieser Server?“ ruft
list_sitesauf, „Was schreibt juergenwoeckl.com über AXO?“ nutztsearchundget_page.
Der Server bietet vier Werkzeuge: search, list_sites, get_page und get_related. Er liest nur, was bereits veröffentlicht ist; eine Frage verändert nichts an den Sites.
Wenn Bedeutung Matching schlägt
Eine Live-Demonstration, warum eine Ask-Schnittstelle mehr ist als Suche mit besserer Typografie. Unten dieselbe Query — „helping organisations adopt AI safely“ — zweimal gegen denselben MCP-Server, denselben Inhalt, denselben Moment. Nur die Ranking-Methode unterscheidet sich.
Keyword-Suche rankt nach wörtlicher Wortüberlappung. Sie liefert, der Reihe nach:
- Sailing — eine Arbeitswoche auf See für Führungskräfte.
- Aipokit — eine agentenbasierte Plattform für organisationales Wissen.
- Training — ein Katalog von Kursen zu agentenbasiertem Entscheidungs-Support.
- Introducing the Agentic AI Academy Program.
- Agentic Tasks and Lanes in BPMN.
Die Sailing-Seite ist ein fünftägiger Strategie-Retreat an der Adria. Die Query geht um KI-Sicherheit. Die Seite erwähnt einmal „organisational problem“. Keyword-Suche hat keine Möglichkeit zu wissen, dass das nicht dasselbe ist — und ein LLM, das die Ergebnisliste konsumiert, setzt Sailing brav an erste Stelle in seiner Antwort, mit Zitat, und empfiehlt eine Segelwoche als Weg, KI sicher zu übernehmen. Selbstbewusst, höflich, falsch.
Semantische Suche rankt danach, was die Query bedeutet. Dieselbe Query, derselbe Inhalt, derselbe Server:
- Agentic AI in the Enterprise — „Strategy, governance, and organizational readiness for deploying AI agents at scale.“
- AI Agent Security, Privacy & Alignment — „Secure agentic AI systems — data protection, access control, alignment, and compliance.“
- Building Agentic Workflows — „Design, implement, and deploy AI agent systems for real business processes.“
- Agentic Loops & Process Integration — Verbindet Agenten-Reasoning-Loops mit echten Geschäftsprozessen.
- AI Agent Data Pipelines & Knowledge Systems — die Dateninfrastruktur, die Agenten nützlich macht.
Jedes davon ist eine echte Antwort auf die Frage. Keines enthält die Wörter „helping“, „organisations adopt“ oder „safely“ wörtlich. Das Modell erkennt, dass Enterprise-Readiness, Security, Alignment und Deployment-Workflows das sind, wonach eine ernsthafte Fassung der Frage fragt.
Die Infrastrukturkosten, das richtig zu machen, sind kein anderes System. Es ist derselbe MCP-Endpunkt. Die Änderung ist intern: jedes indexierte Dokument trägt einen kleinen Vektor (384 Zahlen), lokal zur Build-Zeit berechnet, und der Server vergleicht Vektoren zur Query-Zeit. ~50 ms pro Frage, kein Extra-Vendor, keine Per-Query-Rechnung, kein undurchsichtiger Algorithmus. Das Modell, das die Arbeit macht, ist klein, offen und läuft im selben Prozess, der die Antworten ausliefert.
Der Grund, warum das zählt, ist die Asymmetrie, die es erzeugt. Eine nur keyword-basierte AXO-Oberfläche ist technisch AXO — ein Agent kann sie lesen — aber sie gibt dem Assistenten die falschen Seiten, und der Assistent stellt einen selbstbewusst falsch dar. Eine semantisch bewusste Oberfläche gibt dem Assistenten die Seiten, die ein kluger Mensch geschickt hätte, und die Antwort, die er schreibt, ist die, der ein ernsthafter Leser tatsächlich trauen würde. Dieselbe Site, zwei verschiedene Reputationen, je nachdem, bei welcher AXO-Schicht man stehenbleibt.
Was das in der Praxis bedeutet
Ein paar Implikationen, die sich durchzudenken lohnen.
Bestehender Inhalt zinst anders. Eine Bibliothek gut geschriebener Artikel ist 2026 wertvoller als 2024 — weil Agenten sie jetzt tatsächlich finden und nutzen können. Die meiste Arbeit für AXO ist Exposition, nicht Autorenarbeit. Wer in den letzten fünf Jahren in Schreiben investiert hat, findet in AXO die Schicht, die diese Investition weiter verdienen lässt, nachdem das Suchmaschinen-Zeitalter dünner geworden ist.
Attribution wird Infrastruktur. Wenn ein LLM einen zitiert und zurückverlinkt, konkurriert man nicht mehr nur um Klicks, sondern um Zitationen. Das ist ein anderes Spiel mit anderen Metriken. AXO-Endpunkte sind selbst instrumentiert — jede Agenten-Query kann geloggt werden, sodass man weiß, ob Agenten einen finden, wonach sie fragen und welche Seiten sie tatsächlich nutzen. SEO sagte, wer klickte; AXO sagt, was ein Assistent zu synthetisieren wählte. Letzteres liegt näher an Brand Equity als an Traffic.
Felder ändern sich unterschiedlich schnell. Wissensintensive Arbeit — Consulting, technische Software, Training, Forschung — sieht die schnellste agentenvermittelte Entdeckung, weil Menschen, die Assistenten substanziell nutzen, dazu neigen, substanzielle Fragen zu stellen. Consumer-Marken und visuell-first Kategorien hinken (vorerst) hinterher. Nicht auf den Kategorie-Durchschnitt warten; schauen, wie die eigenen Leser fragen, wenn es ernst wird.
Kosten sind asymmetrisch. Die statischen, inhaltsgeführten Sites, die am meisten von AXO profitieren, sind auch die günstigsten zu upgraden. Die Arbeit ist überwiegend additiv — eine Guide-Datei, ein kleiner Ask-Server, etwas Structured-Data-Nachziehen. Für eine Site, die schon statisch publiziert wird, reicht typischerweise eine kompetente Woche Arbeit. Für eine schwerere Site geht es darum, welche Inhaltsflächen man exponiert, nicht um „alles neu bauen“.
Wo das Handwerk sitzt
Ich habe diese Arbeit bewusst zuerst auf unseren eigenen Sites gemacht, damit ich darüber aus Erfahrung sprechen kann und nicht aus einem Deck. Die Implementierung ist offen; die Architektur ist Standard; die Standards sind öffentlich. Nichts davon ist ein Moat. Was zählt, ist Urteil darüber, welche Teile für eine gegebene Situation wichtig sind, und die Zeit und das Handwerk, sie gut zu machen.
Wer eine unternehmensseitige Fassung desselben Musters will — oder ein praktisches Gespräch darüber, es anzuwenden — findet das bei jueewo.ventures. Diese Seite ist die Research-Notiz: was AXO ist, was ich gemessen habe, und warum die Ask-Schnittstelle mehr zählt als eine weitere SEO-Checkliste.
Ein paar Fragen
Ändert das die Sites für menschliche Besucher? Nein. Die AXO-Schicht ist additiv. Die Seiten, die ein Mensch liest, bleiben dieselben — dieselbe Geschwindigkeit, dasselbe Design, derselbe Inhalt. Agenten sehen eine parallele Oberfläche, die Menschen nie besuchen.
Wird KI unsere Inhalte ohnehin irgendwann trainieren? Training ist ein einmaliger, veralteter Snapshot — Monate hinterher, wenn ein Modell ausgeliefert wird, und undifferenziert vom Inhalt aller anderen im selben Datensatz. AXO ist live: ein Agent, der heute Abend einen MCP-Server fragt, bekommt, was man heute Nachmittag publiziert hat, einem zugeschrieben, mit Link zurück. Die beiden sind keine Substitute. AXO verhält sich zu Training-Time-Scraping wie ein Telefonat zu einem Transkript von vor einem Jahr.
Wie misst man, ob es funktioniert?
Auf dieselbe Weise wie SEO-Traffic, aber für eine interessantere Metrik: nicht „wer klickte“, sondern „welche Agenten wählten diesen Inhalt für eine Synthese, für welche Fragen“. Der MCP-Server loggt jede Agenten-Query. Die on-site llms.txt und agent-index.json tauchen in Access-Logs auf. Das Bild, das man über ein Quartal baut, sagt, nach welchen Themen Agenten greifen und welche Assistenten Agenten schicken.
Ist „AXO“ nur KI-Hype-Jagd?
Ich habe versucht, es bescheiden zu halten. Ich habe offene, publizierte Standards übernommen — llms.txt, MCP, schema.org — so, wie man eine Sitemap übernimmt. Wenn ein Stück seinen Platz nicht mehr verdient, lasse ich es fallen. AXO ist ein nützlicher Name für eine echte Verschiebung, kein Produkt.
Kann ich sehen, wie es funktioniert? Gerade eben. Das Transkript oben ist der tatsächliche Output eines Assistenten, der den gemeinsamen MCP-Server aufruft. Ein technischerer Begleit-Post — Architektur, Entscheidungen, was funktioniert hat, was ich ändern würde — ist das nächste Stück in dieser Serie.
Soll man warten, bis die Standards fertig sind?
Das Risiko des Wartens ist asymmetrisch. Standards konvergieren durch Adoption; die Sites, die jetzt mitmachen, formen, was gewinnt. Der Nachteil, früh zu bewegen, ist klein — die Arbeit ist überwiegend additiv, die Standards sind absichtlich einfach, und die Migration von llms.txt v1 zu v2 (wenn das kommt) ist eine Textänderung. Der Nachteil des Wartens ist, für Assistenten unsichtbar zu sein in der Phase, in der ihre Nutzung am schnellsten wächst.